DeepSeek-R1
纯强化学习 · 显式长推理链路
128K 超长上下文窗口
实时思维链回溯分析
DeepSeek api开放平台协同
DeepSeek Harness 统一评测
免登录即刻开启多轮问答
DeepSeek 网页版多端即时同步演示
请详细解析 DeepSeek-R1 的四列核心能力如何在复杂逻辑推演中形成协同效应?
[思维链展开 // 耗时 3.9s // Token: 426]
1. 内存基底:MLA 机制降低显存峰值,使得万字上下文保持极低计算时延;
2. 算法核心:纯强化学习赋予模型自博弈与多步分支自发回溯能力;
3. 稀疏路由:256 专家 MoE 精确分发细分专业知识子模块;
4. 长程贯通:128K 超长窗口确保前后论据与结论严密闭环。
DeepSeek-R1 的四列能力构成了一个自洽且高效的技术飞轮:MLA 与 MoE 稀疏激活在底层极大平抑了算力消耗,为纯强化学习长思维链的自由推演提供宽广舞台,最终在 128K 完整会话中实现向未知领域的扎实探索。

把复杂长思维链完整留在浏览器中

DeepSeek 网页版致力于为研究人员、工程师与深度思考者打造极致沉浸的交互场域。在长达数十轮的复杂演算过程中,界面零重载、零白屏,思维链每一步展开都清晰可辨。

结合 DeepSeek api开放平台 提供的百万级前缀缓存加速能力,二次调用与后续追问几乎瞬时呈现,让探索未至之境变得平顺流畅。
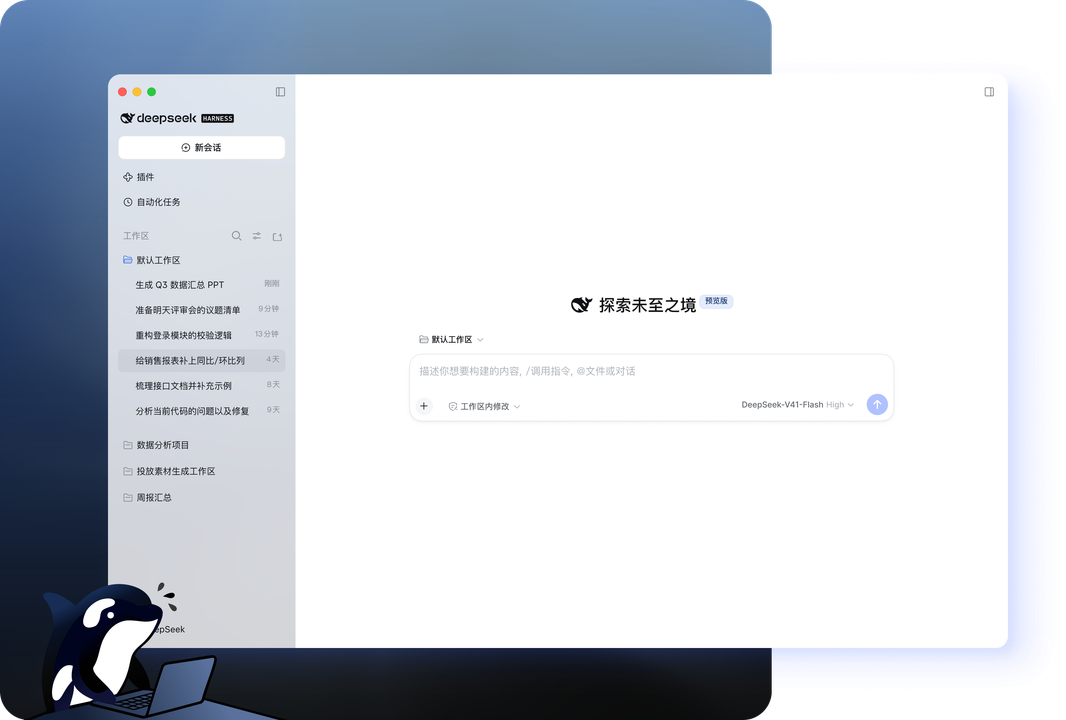
DeepSeek 网页版高并发会话吞吐架构展示